Flare™ V13 正式发布——借助 AI 赋能的分子生成与3D-R基团探索,更快发现更好的分子
摘要:Cresset 正式发布 Flare V13,本次更新集中在三个方面:(1)全新 AI 设计工具 Spark™ AI。 它把 REINVENT4 的 LibINVENT 方法与 Cresset 专利 3D 技术结合,用 AI prior 生成生物等排 R 基团,突破常规 Spark 片段数据库的化学空间边界。Spark AI 沿用原有 Spark 向导界面,既可单独使用,也可与传统片段库、试剂库在同一次实验中混用,下游的聚类、辐射图与 Spark 打分流程完全不变。在 CDK2(PDB:1OIT)案例中,Spark + Spark AI 联合实验的前 500 个结果按 BIF% 排名几乎在每个位次上都优于任一单独方法,且前 200 名中两种来源近乎平分——说明二者互补,AI 恰好补足了对高质量结果的贡献。(2)增强版 MolGenAI。 在原有 2D 相似性之外,新增两个 prior 重训练选项:3D 相似性打分(偏向与参考结构高静电/形状相似性的分子)与对接打分(偏向预测能良好对接进靶点的分子),把 3D 静电、形状与结合信息前置到生成阶段。以 RIPK1(PDB:5HX6)为例,3D 相似性重训练后 Sim 中位数由 0.516 提升至 0.570;对接重训练后 LF Rank Score 中位数由 −5.85 降至 −7.98,两项差异均具统计学显著性。(3)Relative FEP 增强。 新增「端基翻转蒙特卡洛(Terminal Flip Monte Carlo)」解决端基旋转异构体被困导致的采样不足;新增 Boresch ghost 修正处理杂化状态变化引起的变换误差;并加入副本交换矩阵(Replica Exchange matrix),以及「按误差 vs 实验值 / 预测值着色连线」两项 FEP 图诊断工具。所有新功能均无需用户额外手动设置。
我们很高兴宣布 Flare V13 正式发布。本次更新为平台带来了一整套强大的全新 AI 工具,同时对 Relative FEP 进行了增强,并包含一系列易用性改进。
全新的 AI 设计工具 SparkTM AI 与增强后的 MolGenAI,将 Flare 的生成式化学能力拓展到新的化学空间领域,并让用户能够借助 Cresset 的 3D 相似性(3D Similarity)与分子对接(docking)信息来引导分子生成。
与此同时,Relative FEP 的进一步改进延续了 Flare V12 引入的各项增强。
超越已知 R 基团:用 Spark AI 探索新的化学空间
Spark AI 是一种为先导化合物优化(lead optimization)寻找生物等排 R 基团替换的全新方法。它把 REINVENT4 的 LibINVENT 方法[1](使用在 ChEMBL 和 PubChem 上预训练的 prior)与 Cresset 的专利 3D 技术相结合,在 3D 分子性质的引导下设计全新的 R 基团。这使得研究者可以探索常规 Spark 数据库未覆盖、但同样具有相关性的化学空间区域。
Spark AI 无缝集成到大家熟悉的 Spark 向导(Spark Wizard)界面中,因此无需学习新操作,也无需额外设置。在 Spark 向导内,AI prior 既可以与传统的 Spark 片段库和试剂库并列选择,也可以取而代之。计算结果会回写到标准配体表格(ligands table)中,与现有的 Spark 工作流无缝衔接。
聚类分析、辐射图(radial plots)、Spark 打分以及其他下游分析工具,都可以像对待传统 Spark 结果一样直接使用,从而从 AI 生成的化学结构中提炼出有价值的见解。
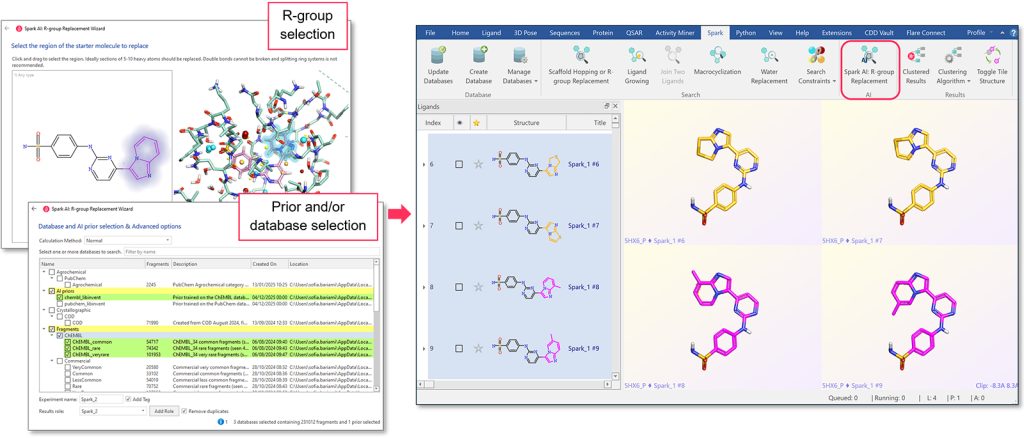
图 1. Spark AI:与 Spark 同样熟悉的界面,却带来更广阔的化学空间探索能力。
由于 Spark AI 生成的片段与来自 Spark 数据库的片段采用完全相同的打分与过滤方式,两种方法可以在同一次 R 基团替换实验中组合使用。
图 2 展示了在单次实验中把 Spark 与 Spark AI 结合使用所带来的收益。实验以 PDB:1OIT 复合物(细胞周期蛋白依赖性激酶 2,CDK2 的一个结构)中的共晶配体作为起始分子,并选择咪唑并[1,2-a]吡啶稠环体系作为修饰位点(见图 1 左上角面板)。
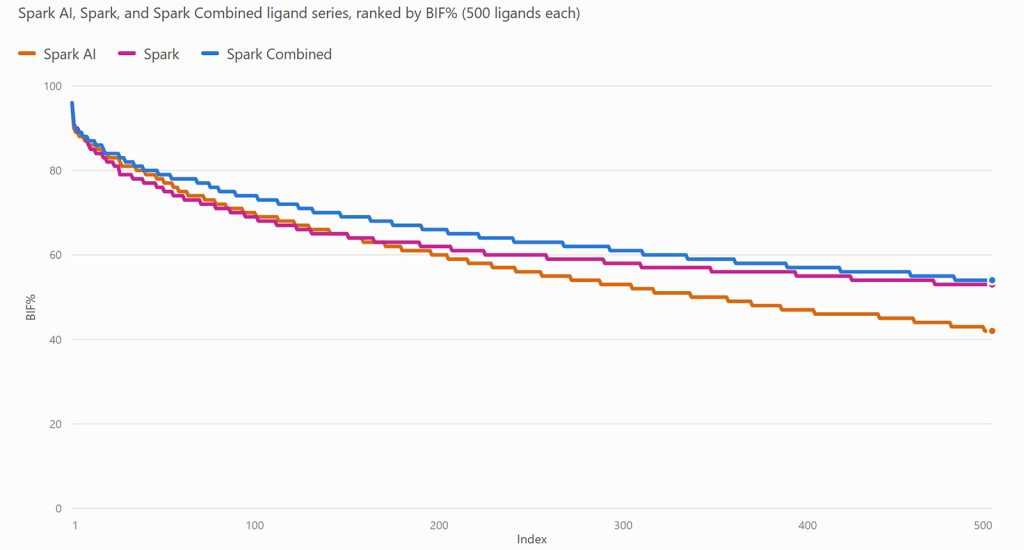
图 2. 分别来自 Spark、Spark AI 以及 Spark + Spark AI 联合实验的各 500 个结果按 BIF% 排名——联合实验的曲线(蓝色)在几乎每一个排名位置上都高于两种单独方法。
当把每种方法各自的前 500 个结果针对同一起始分子进行排名时,联合实验在几乎每一个排名位置上都取得了比任一单独方法更高的分数(BIF%,一种归一化的相似性打分),说明来自片段数据库的片段与 AI 生成的片段是互补的 R 基团替换来源。
考察这些联合结果究竟来自哪里,就能看出其中的原因(图 3)。
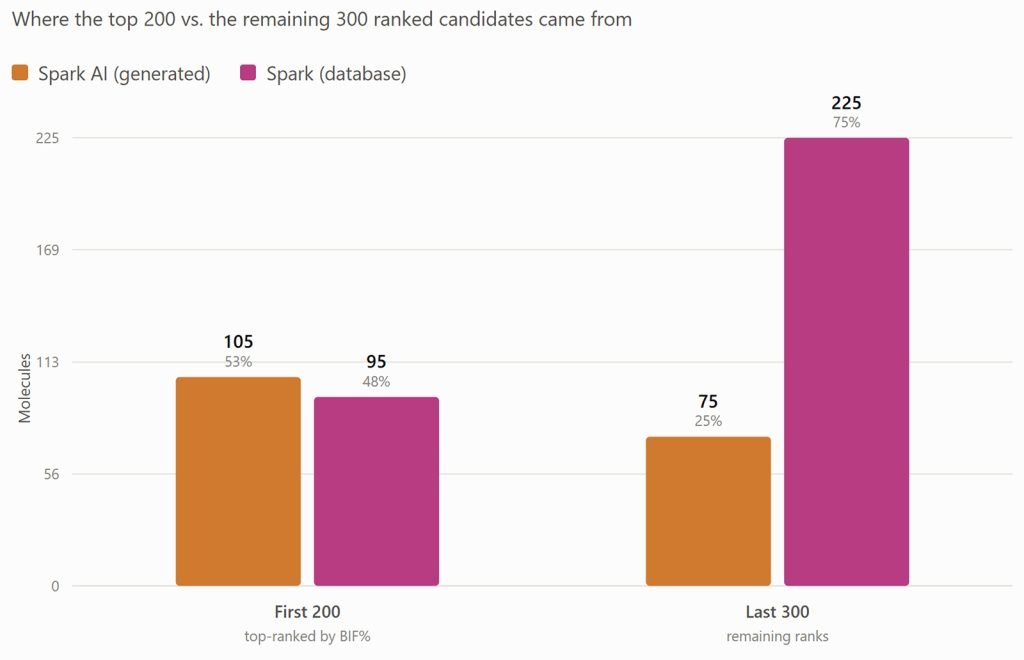
图 3. 在 Spark AI + Spark 片段数据库联合实验中,排名前 200 与其余 300 个候选分子分别来自哪种来源。
总体上,500 个结果中约三分之二来自数据库片段,三分之一为 AI 生成;但这一比例在排名区间内并不均匀。在前 200 名中,两种来源几乎平分秋色,清晰地体现出 Spark AI 对最高质量结果的贡献——而这恰恰是最关键的地方。
增强版 MolGenAI:引导新分子生成朝向相关的 3D 性质
MolGenAI 是 Flare 平台基于 REINVENT 技术开发的 AI 从头分子生成工具,如今新增了可脱离二维相似性来引导分子生成的全新方式。新增的 3D 相似性打分(3D Similarity Scoring)重训练选项能够对 REINVENT 先验模型(prior2)进行微调,优先生成与一个或多个参考结构具备高 3D 静电及形状相似性的分子。新增的对接打分(Docking Score)选项利用 Flare 的分子对接打分,对先验模型做微调,使其偏向生成预计可在选定靶点中实现良好对接的分子。这两项新功能从生成阶段伊始,就将三维静电、分子形状与结合作用信息纳入分子生成流程。
图 4(左)展示了 PDB: 5HX6,即 RIPK1(受体相互作用丝氨酸/苏氨酸蛋白激酶 1)的晶体结构。RIPK1 是一种人类信号激酶,调控炎症、细胞死亡、凋亡与坏死性凋亡。该 REINVENT prior 在两个独立实验中分别被重训练:一个使用针对 5HX6 共晶配体的 3D 相似性,另一个使用对接进 RIPK1 结合位点的信息。从重训练后的 prior 中采样得到的分子会经过辐射图(Radial Plot)打分过滤,以使其理化性质保持在期望的阈值范围内。随后,用重训练 prior 生成的 2D 分子会被叠合(align)到共晶配体上,或对接进 RIPK1 结合位点。图 4(右)给出了经 3D 相似性重训练的 prior 的一个示例输出,可以看到与蛋白之间的一个重要相互作用得到了保持。
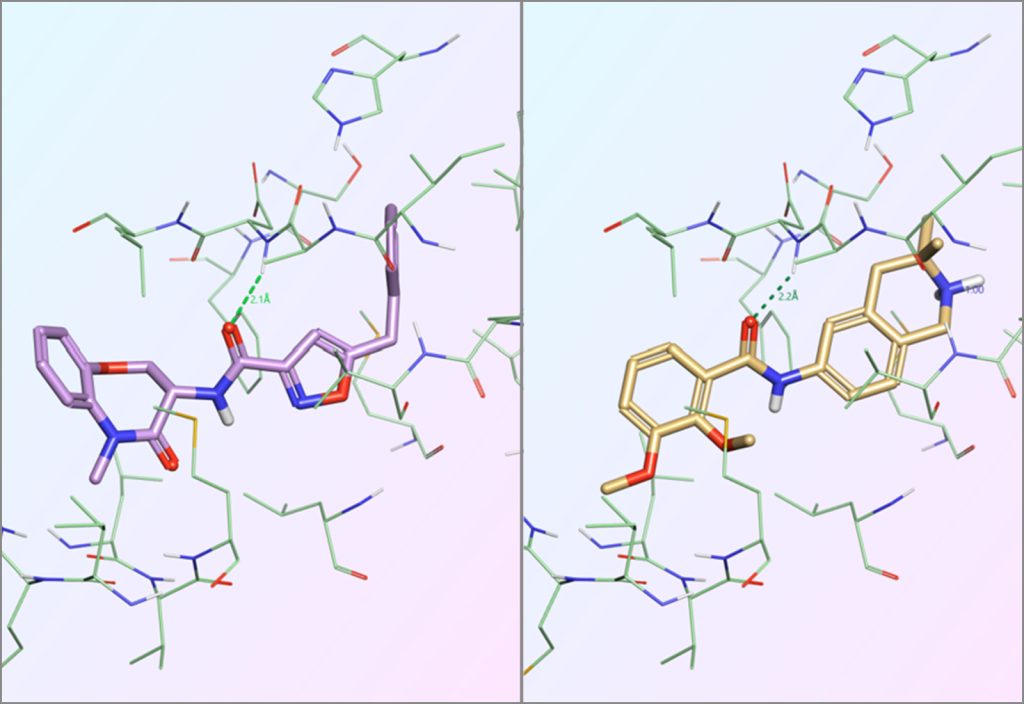
图 4. 使用 MolGenAI 新增的 3D 相似性重训练方法生成的分子(右,金色)重现了参考配体(左,紫色)所形成的关键氢键相互作用,尽管 MolGenAI 并不直接了解该蛋白结构。
图5对比了两组分子:一组由原始REINVENT先验模型(未重训练)生成,另一组采用”3D相似性重训练”后生成。两组分子均与RIPK1共晶配体进行叠合,并采用Cresset的三维静电与形状相似性指标(Sim,取值1代表完全相似)对叠合结果打分。采用原始REINVENT先验模型生成的大量分子具有相对较高的Sim值,但分布图中存在大量低Sim打分的长尾(long tail)分子。基于3D相似性进行重训练并增加径向图(Radial Plot)筛选后,全部生成分子群体向与RIPK1配体静电/形状匹配度更高的方向偏移。经3D相似性重训练的先验模型所生成分子,其中位相似性得分为0.570;作为对照,采用未重训练REINVENT基线模型、对同一参考结构叠合得到的中位相似性为0.516,二者差异具有统计学显著性。
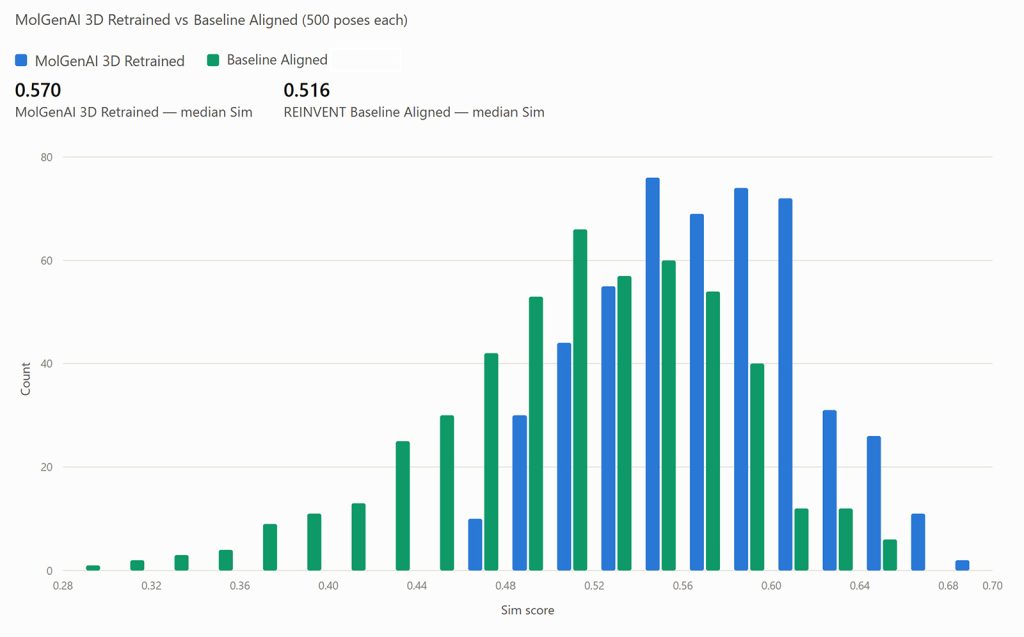
图 5. 用 3D 相似性对 MolGenAI 进行重训练,可使生成分子的分布相较未训练基线整体向更高的静电/形状相似性打分移动。
基于对接分值进行训练,同样观察到生成分子向预测结合能力更强的方向偏移(图 6):经过重训练与筛选后生成的分子,LF Rank Score 中位数为 – 7.98;作为对照,未重训练基线模型在同一靶点上对接得到的分子中位数为 – 5.85(LF Rank Score 负值越大,代表预测结合能力越强),体现了重训练与筛选策略带来的结果富集效应。
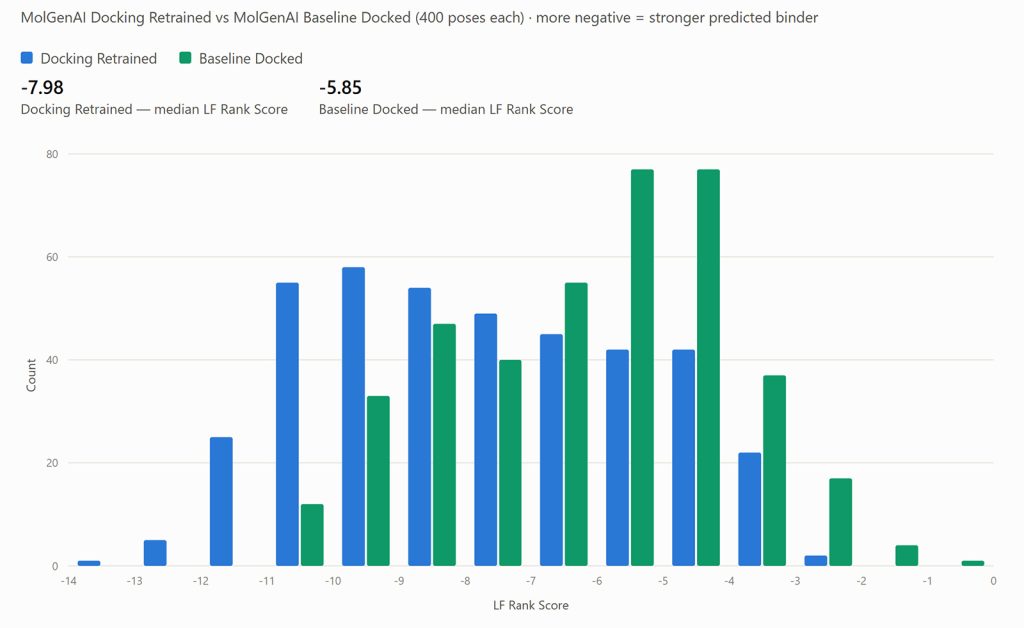
图 6. 使用对接打分重训练的 MolGenAI prior 所生成的分子,相比在同一靶点上对接的未训练基线,明显偏向更强的预测结合(更低的 LF Rank Score)。
Relative FEP:更强的采样与更清晰的诊断
Flare FEP 新增两项功能,可在无需用户额外手动设置的情况下提升 Relative FEP 计算的精度。
在模拟过程中,端基旋转异构体(terminal rotamers)可能被困在单一的旋转异构状态中,因为标准分子动力学对这类跃迁的采样过慢。这会导致采样不足,并使自由能估计不够准确。Flare FEP 新增的「端基翻转蒙特卡洛(Terminal Flip Monte Carlo)」选项(图 7)通过定期把端基旋转到新的取向来解决这一问题,确保所有相关旋转异构体都被高效采样,从而使计算收敛到更准确的结果。
与此同时,新的 Boresch ghost 修正可以纠正由分子被扰动部分的杂化状态变化所引起的变换误差。
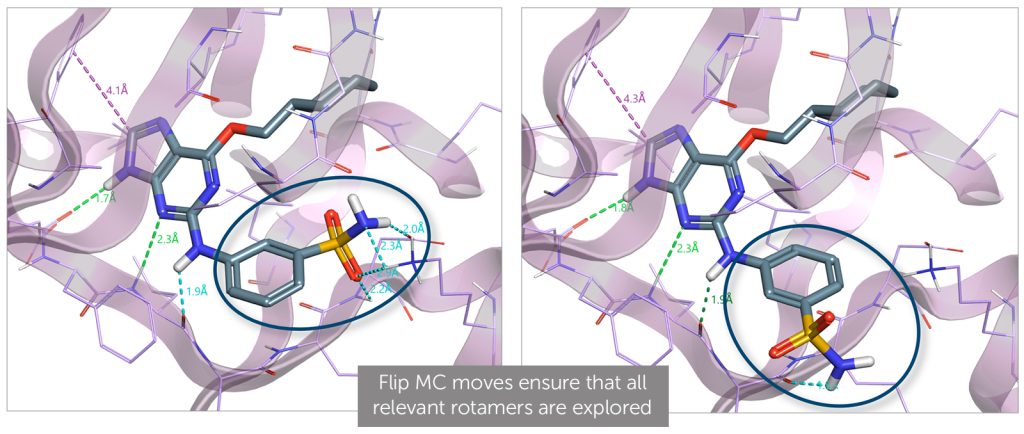
图 7. 端基翻转蒙特卡洛移动确保端基不会在动力学上被困于某一旋转异构状态,从而改善 FEP 计算的采样,并相应提升其精度。
在 Flare V13 中,排查 FEP 计算问题也更容易了。新增的副本交换矩阵(Replica Exchange matrix)可显示副本在相邻 lambda 窗口之间发生交换的频次,与现有的重叠矩阵(Overlap Matrix)互为补充,能够更全面地反映计算的采样质量。
新增的 “按链接着色(Color links by)” 选项(图 8)支持用户根据与实验值或预测值之间的 ΔΔG 差值,对 FEP 网络图中的连接(link)进行着色。按相对实验值的误差着色功能,可以直接定位与实验值偏差最大的连接,无需通读结果总览表格。按相对预测值的误差着色则便于快速识别 FEP 网络图中的环闭合误差。
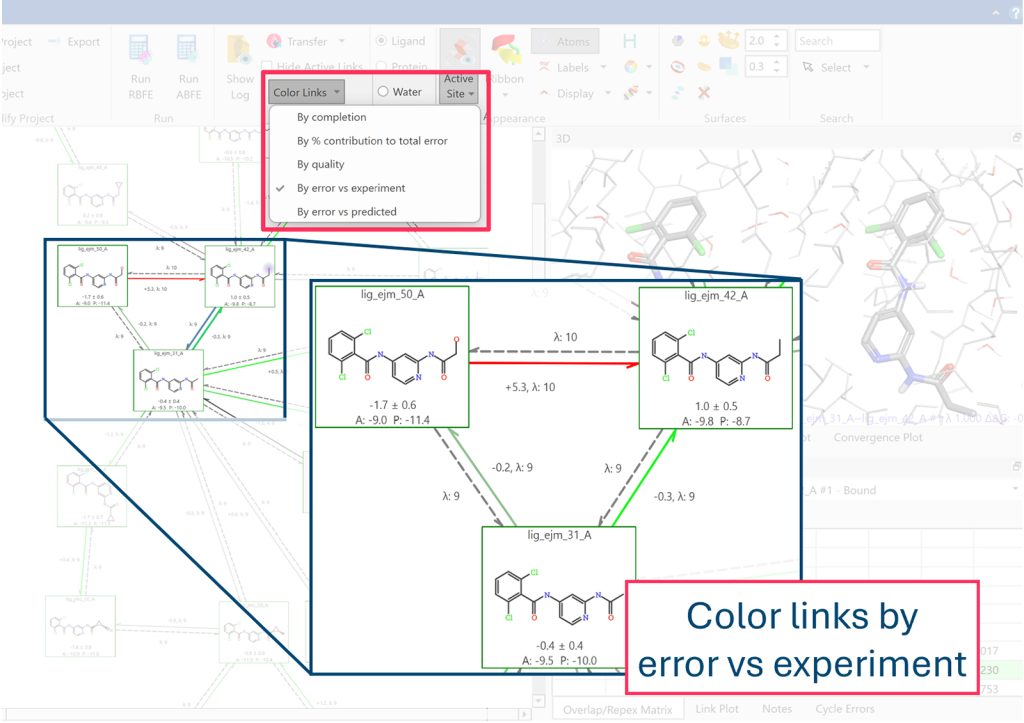
图 8. Flare FEP 中新增两个「着色连线」选项:「按误差 vs 实验值着色连线」与「按误差 vs 预测值着色连线」,分别通过识别 ΔΔG 与实验值或预测 FEP 值之间的显著差异,帮助用户轻松排查 FEP 图。
用 Flare V13 加速你的研究
Flare V13 在持续提升相对自由能微扰(Relative FEP)计算精度与稳健性的同时,为平台引入了强大的全新 AI 工具。
欢迎联系我们申请试用,抢先体验 Flare 的各项最新功能。我们的专家团队将指导你完成安装与配置;内容丰富的教程——涵盖基础工作流到高级计算方法——将确保你能够顺利上手。借助 Flare V13您能够加速研发进程、拓展探索边界,设计出影响力卓越的分子。
联系我们:020-38261356 info@molcalx.com
参考文献
- Fialkova V. et al. LibINVENT: Reaction-Based Generative Scaffold Decoration for in Silico Library Design, J. Chem. Inf. Model. 62, 9 (2022).
- Loeffler, H.H., He, J., Tibo, A. et al. Reinvent 4: Modern AI–driven generative molecule design. J Cheminform 16, 20 (2024).