AI Agent 驱动的专利药物数据挖掘——从专利原文到 SAR 分析
摘要:药物专利挖掘是靶点立项、竞品调研与构效关系(SAR)研究的基础,但传统流程中专利检索、文档下载、化学结构与活性数据提取依赖大量人工操作,重复劳动多、耗时久且易引入人为误差。本文以礼来 DACRA 靶点小分子专利 WO2025240893 为案例,构建一套基于豆包、Workbuddy 等 AI Agent 的端到端自动化管线:利用 Agent 定时任务持续监测 WIPO 专利动态,自动完成专利文档下载;借助定制 Skill 结合 DECIMER 化学 OCR,从专利 PDF 中区分中间体与实施例化合物,批量提取 SMILES 结构、AMY3R/CTR 活性数据,并通过 RDKit 分子量校验做数据质控;输出的标准化数据集可直接接入 Flare 开展下游SAR分析,完成 R - 基团定性解析与 Field-based 3D-QSAR 定量建模。案例证实 AI Agent 可显著削减专利数据整理的人力投入,提取得到的分子与活性数据能够无缝衔接 SAR 分析工作流。正如行业观点所指出,当前 AI 赋能药物研发的核心价值不在于直接生成全新分子,而在于自动化重构繁琐的文献与数据处理流程,释放药化与计算化学人员精力,聚焦构效解读与分子优化等核心科研决策。本文配套整理了礼来 3 项 DACRA 专利的结构化数据集,可供同行复用参考。
前言
当前AI药物研发的公众讨论中,舆论往往聚焦于“AI从头生成全新药物分子”的突破性场景。这类前沿范式极具想象力,也让行业普遍高估了生成式模型的即时落地价值。但回归真实的药物研发产业与计算化学落地场景,真正规模化提升研发效率、创造实际科研价值的,并非单次惊艳的新药设计案例,而是可复用、可标准化的自动化研究工作流,让繁杂的计算化学分析工作高效、常态化落地。这一核心观点与行业研究者 Ash Jogalekar1 的论述高度契合:在大模型赋能药物研发的当下,真正的变革不在于AI直接“发现新药”,而在于AI以代码化、自动化的方式重构研发流程。基于这一理念,笔者长期依托TRAE搭建专属自动化科研工作流,通过工具赋能剥离文献整理、数据提取等重复性事务,将核心精力聚焦于药物研发的科学分析与决策环节。基于此,本文以礼来公司(Lilly)DACRA靶点发明专利(WO2025240893)为实战案例,完整演示依托豆包、Workbuddy等AI Agent工具,完成专利文献批量抓取、分子结构与生物活性数据智能抽取的全流程,再结合Flare工具开展构效关系(SAR)分析,构建一套高效率的药物专利挖掘与SAR研究管线。
用定时任务追踪专利进展
Marvis、豆包、Workbuddy等AI Agent的核心优势之一,是可自动化执行周期性定时科研任务,实现靶点专利动态监测与全景追踪。依托豆包搭建定时监测任务,按月自动检索WIPO专利库中礼来公司公开的小分子DACRA相关专利,实现前沿技术动态的常态化跟进。图1为9月24日定时任务的检索结果,完整梳理出本年度礼来小分子DACRA领域的专利布局情况。
图 1. 在WIPO中查询LILLY公开小分子DACRA专利的定时任务截图
依托AI Agent的自动化检索能力,可快速完成年度礼来非肽类小分子DACRA专利全景梳理,本年度该团队共计公开3项核心专利,其中2项集中于2026年9月公开,清晰呈现其靶点药物的研发迭代与布局节奏。相较于人工定期检索、手动汇总的传统模式,AI定时任务可实现无人值守、高频追踪、结构化汇总,大幅降低前沿专利调研的时间成本。
专利下载
AI Agent可高效完成专利文献的全自动批量下载与标准化预处理,大幅简化传统专利获取的繁琐流程。以豆包为例,仅需输入专利号指令,即可在数分钟内完成WIPO官方专利全文的抓取、格式解析与文件分类归档。本文以WO2026193092专利为例,完整复现了AI Agent一键下载专利全文、拆分结构化文件、归档项目目录的全过程,结果如图2所示。
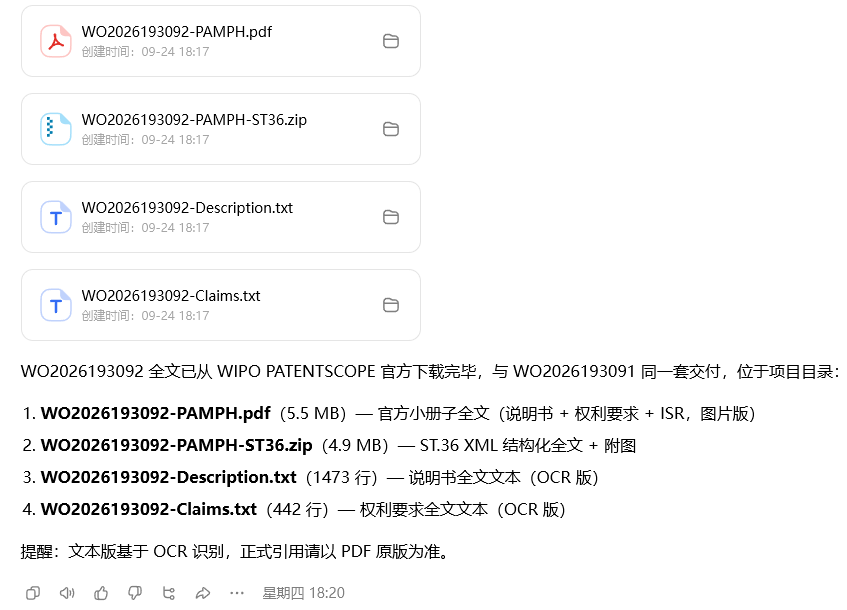
图 2. 豆包执行专利文档下载任务
下载成果包含PDF官方全文、ST.36结构化XML文件、OCR文本说明书与权利要求书等多维度资料,实现专利原始数据的完整留存,为后续结构与活性数据提取、文本解析、数据校验提供完整数据源支撑。
从专利文档里提取化学结构与活性数据
在药物专利挖掘工作中,化学结构识别、化合物匹配、活性数据归集是最耗时、最繁琐的重复性工作。单一专利往往包含数百个化合物结构,且实施例结构、中间体、活性测试数据零散分布于全文不同页面,人工筛选、结构绘制、数据匹配极易出现遗漏、错配、录入误差,严重制约CADD与药物化学的研究效率。笔者此前已实现基于Flare Python拓展与DECIMER化学OCR工具的结构式图片转SMILES流程2,在此基础上,依托WorkBuddy定制专属专利数据提取技能(Skill),搭建了标准化、自动化的专利结构与活性数据提取工作流,实现全流程无人化处理。
为兼顾提取精度与算力效率,本次工作流优化了Token调用策略,通过页面区间精准切割、定向解析目标内容,规避全文输入的冗余消耗。针对WO2025240893专利,精准锁定活性测试段落与化合物结构段落的页面区间,定向提取AMY3R、CTR双靶点活性数据与对应实施例化合物结构,核心提示词指令如下:
@skill:decimer-pipeline @C:/Users/gkxiao/Documents/molcalx/DACRA/WO2025240893-llily/WO2025240893-Lilly.pdf 附件是WO2025240893的PDF版。在这篇专利文档中,inked-page第378-385页给出了AMY3R Assay(AMY3R EC50, nM与Emax, %; 部分化合物10点格式,部分化合物20点格式),表单从左到右依次给出化合物的Example编号(可能含有参比化合物)、EC50(nM,数值或分级数据) 、EMax(%)。inked-page第385-391页给出了CTR Assay(CTR EC50, nM与Emax, %),表单从左到右依次给出化合物的Example编号(可能含有参比化合物)、EC50(nM,数值或分级数据) 、EMax(%)。Example编号对应的化合物结构可从Inked Page第247-377页中获得,注意区分中间体与实施例化合物,有的实施例化合物包含在以Example开头的段落中,有的在表格式列表中。请整理活性数据(包括AMY3R与CTR的EC50分级数据与Emax),并根据化合物编号,从Inked Page第378-385页实施例化合物中提取相应的化合物结构。未测的数据以ND表示,不要留空白值。
工作流执行完成后,WorkBuddy可输出多维度标准化交付文件,涵盖结构数据集、活性数据表、可视化核对表、完整提取报告等成果,交付物清单如图3所示。
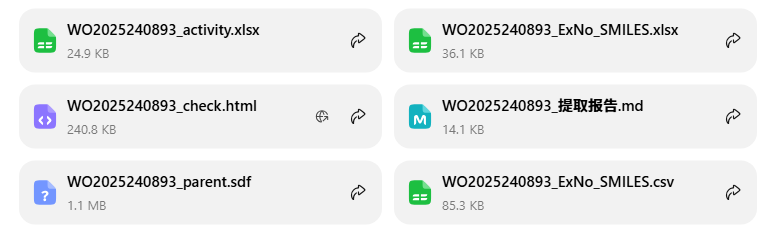
图 3. 在Workbuddy将执行结构与活性提取SKILL后的交付物
其中,可视化核对网页文件可直观展示各实施例化合物的结构式、专利出处、双靶点EC50、Emax活性数据,支持快速浏览与人工复核。以WO2025240893专利开篇实施例为例,结构化数据展示效果如图4所示,数据维度完整、对应关系清晰。
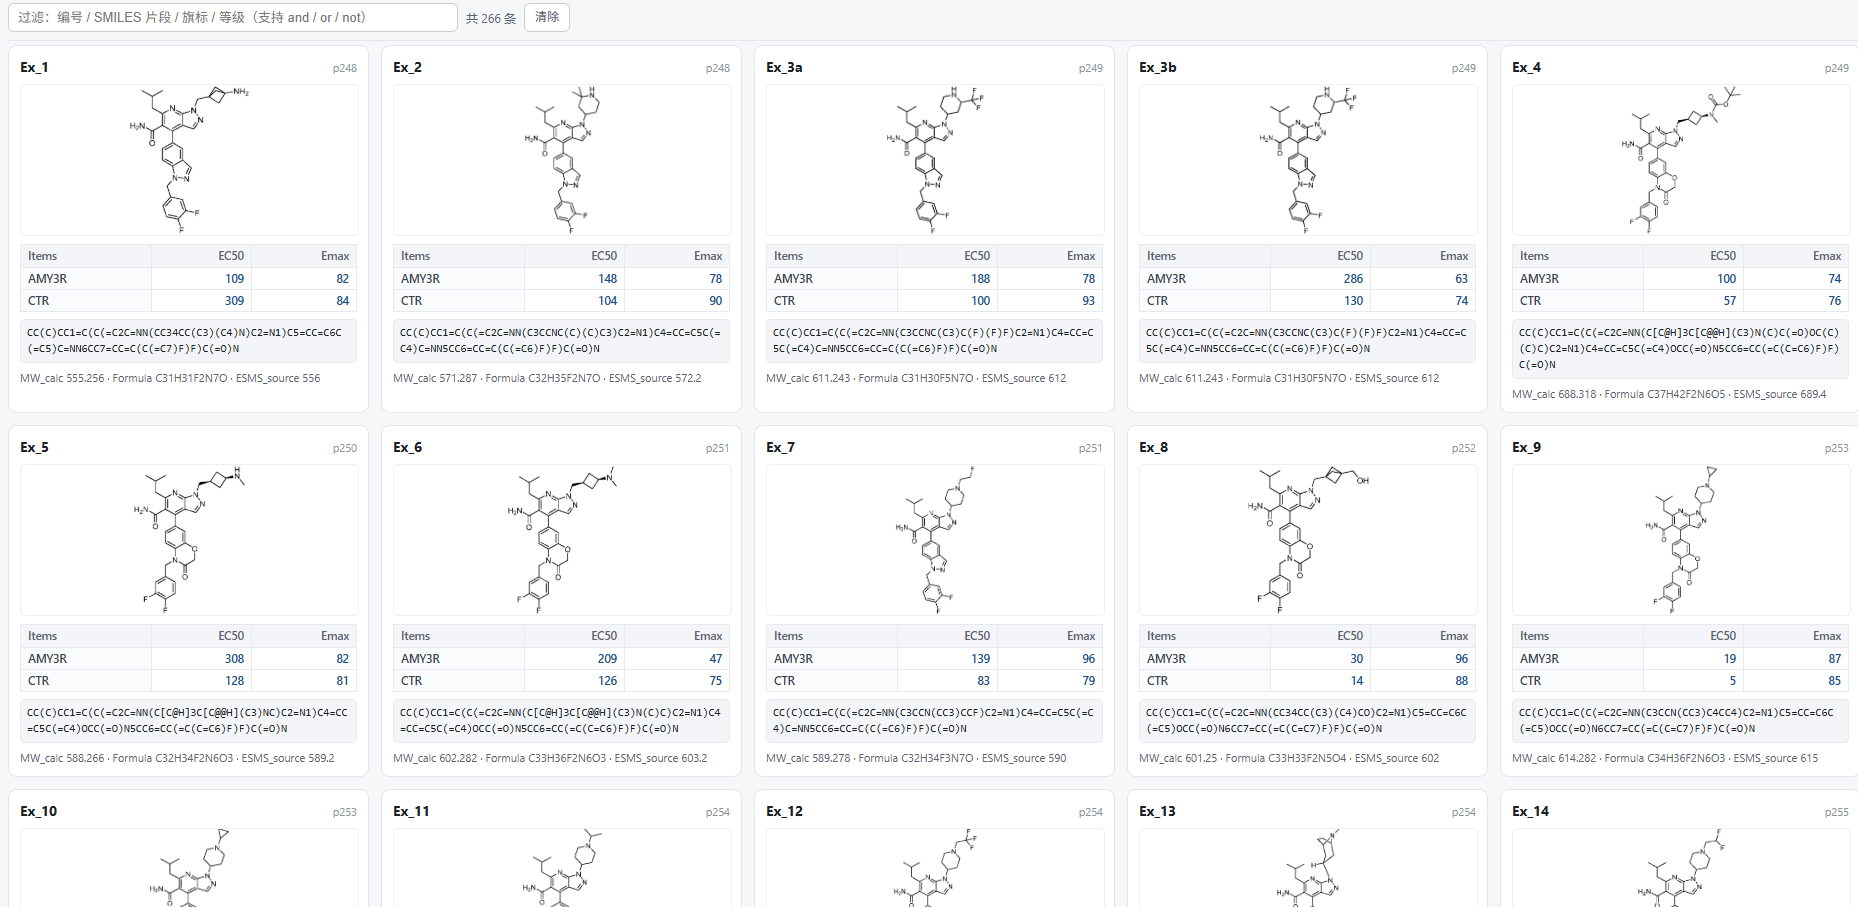
图 4. WO2025240893检查表头几行示例
为保障数据准确性,工作流内置多重校验机制:依托专利原文LCMS分子量数据与RDKit计算分子量进行交叉比对,对异常、疑似错误的结构数据进行高亮标注,便于后续在Flare、Schrodinger等专业CADD软件中精准修正。同时,自动生成Markdown格式提取报告,完整记录PDF解析、结构识别、数据匹配、异常处理的全流程细节,可随时复盘溯源,也可直接导入AI工具进行二次解析。
其中“提取报告”记录了Workbuddy如何处理PDF文件,并从中提取化合物结构、活性数据、遇到了什么问题、如何解决等细节。“提取报告”以Markdown格式保存,可以用VS code、Workbuddy或者专门的Markdown浏览器打开,你也可以直接丢到各种AI聊天框里进行阅读。
目前,礼来本年度公开的3项小分子DACRA核心专利均已通过该AI Agent工作流完成标准化整理,配套数据集可直接解压使用,大幅省去人工整理、录入、校验的海量工作量,输出成果可直接对接药物化学分析与计算化学建模工作。
R-基团分析
经AI Agent自动化提取、清洗、校验得到的结构化分子与活性数据集,可无缝衔接下游构效关系研究。本文依托Cresset Flare平台开展R-基团分析(R-Group Analysis, RGA)3,聚焦系列化合物的结构修饰规律与活性差异机制,快速挖掘优势结构特征。RGA分析的核心前提是确定系列化合物的公共母核,本文结合专利马库什通用结构,同时兼容RDKit最大公共子结构(FMCS)算法4辅助核验,在Flare 3D可视化界面中精准定义核心母核骨架3,如图5所示。
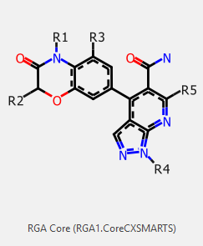
图 5. R-基团分析(R-Group Analysis,RGA)预定义的母核
确定公共母核后,通过Flare RGA模块完成各取代位点的基团拆解与活性关联分析,依托箱线图(Boxplot)与热图(Heatmap)实现单一位点基团活性规律、多位点基团组合协同效应的双重解析。其中,RGA箱线图可直观呈现单一取代位点不同基团的活性分布、使用频次与优劣性,本文针对母核R1取代位点开展分析,明确不同取代基团对AMY3R靶点活性的影响规律,结果如图6所示。
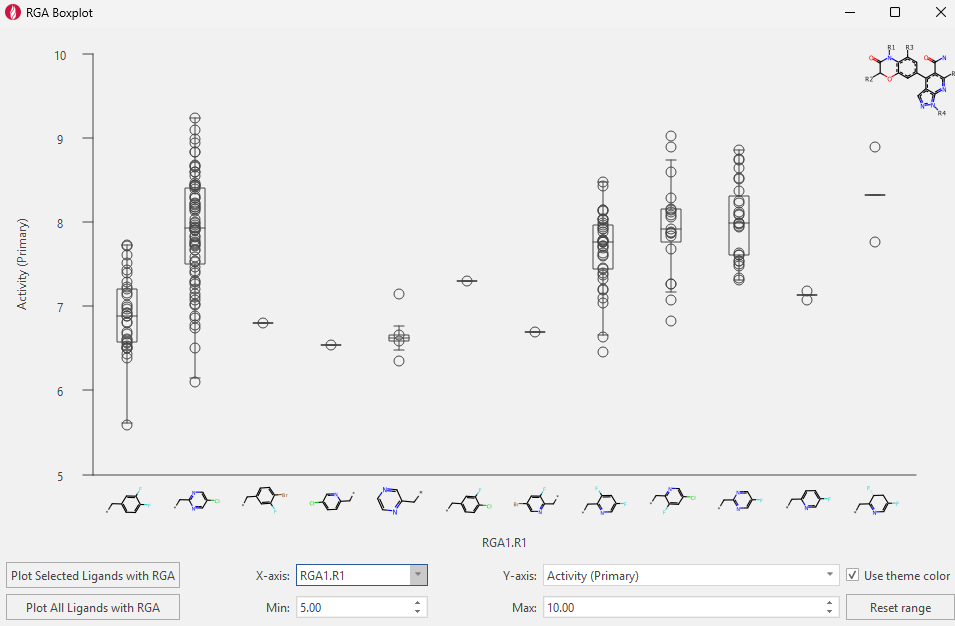
图 6. 用RGA Boxplot分析母核R1位置不同R基团与AMY3R EC50活性的关系
RGA热图可进一步实现双取代位点的组合效应分析,以颜色梯度量化不同R基团组合的活性优劣,精准识别高活性优势组合、规避负效基团搭配。本文选取R1、R2两个关键取代位点构建二维活性矩阵,清晰揭示基团组合与AMY3R激动活性的构效关联,为后续分子优化提供直接指导,分析结果如图7所示。
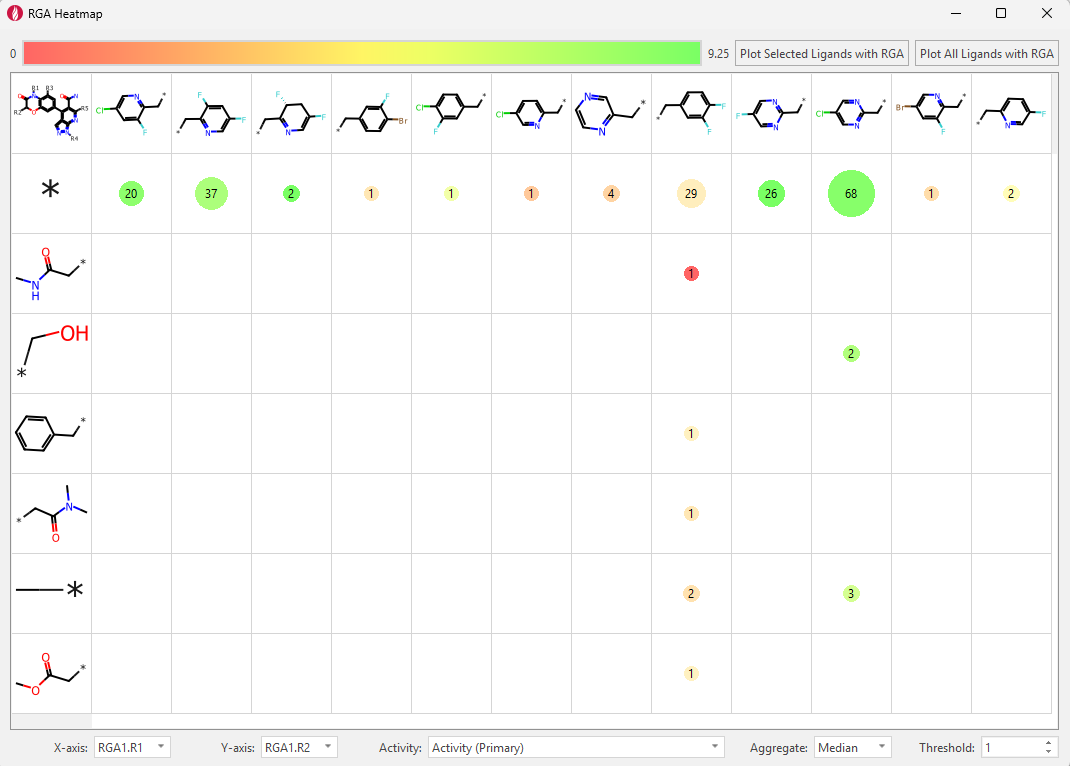
图 7. 用RGA Heatmap分析母核R1、R2位置R基团组合与AMY3R EC50活性的关系
Flare RGA更多的用法请参见前文:Flare的R-基团分析(R-Group Analysis)。总的来说,RGA可以帮你快速定位到最有价值的R基团、以及R基团组合。
整体而言,RGA分析可快速剥离无效结构信息,精准锁定优势取代基团与最优基团组合,实现定性层面的SAR规律总结。若需进一步量化各取代基团的活性贡献,可结合Free-Wilson分析方法,通过Zhao等人5提出的AI增强型模型(AIR)不仅可计算各位点基团的贡献系数,同时支持训练集未见的全新R基团的活性预测,进一步拓展构效研究的应用场景。
3D-QSAR分析
在缺乏AMY3R/CTR靶点-配体复合物晶体结构的前提下,基于力场的3D-QSAR是解析化合物立体、静电构效规律、构建定量预测模型的核心手段。本文依托Flare平台,基于AI Agent提取的标准化数据集开展场基3D-QSAR建模研究。研究选取专利高活性实施例化合物116为参比结构,经构象搜索与QM几何优化筛选最低能构象,通过公共子结构叠合完成全系列分子对齐。采用7:3比例划分训练集与测试集,剔除立体化学归属模糊的消旋体结构,最终以164个分子为训练集、74个分子为测试集,基于LOO交叉验证的PLS算法构建针对AMY3R EC50的3D-QSAR模型,模型核心统计学参数如表1所示。
| Components | R² | Q² (LOO) | RMSE (train) | RMSEₗₒₒ | R²_test | RMSE_test | τ_test |
|---|---|---|---|---|---|---|---|
| 5 | 0.858 | 0.641 | 0.275 | 0.437 | 0.699 | 0.437* | 0.599 |
τ: Kendall’s tau
模型各项统计学指标中等偏上,具备良好的拟合能力、预测精度与泛化能力,可稳定用于系列化合物的活性预测与构效机制解析。通过可视化模型立体与静电系数场,可直观定位影响靶点活性的关键结构区域:静电势、立体位阻的最优分布特征,能够直接指导后续分子结构修饰与优化。模型系数可视化结果如图8所示。
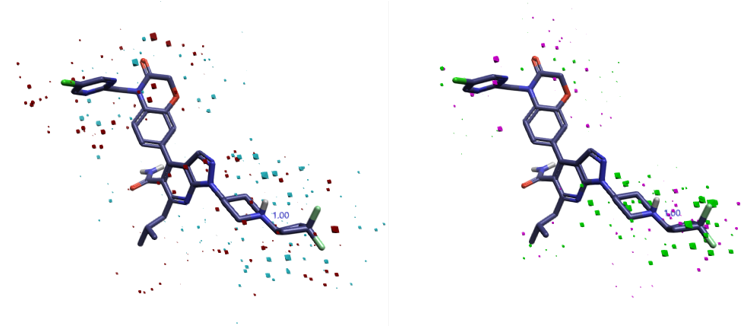
图 8.AMY3R EC50 活性 Field-based QSAR模型系数图。左:静电系数(红色:正静电势对活性有利;青色:负静电势对活性不利);右:立体系数(绿色:增加立体对活性有利;紫色:增加立体对活性不利)。以WO2025240893实施例化合物116为参比。
本研究当前采用单一低能构象作为建模参比,存在一定优化空间。后续可引入FieldTemplater技术6-8与Co-Folding方法,精准预测化合物真实生物活性构象,替代单一低能构象,进一步提升3D-QSAR模型的生物学合理性与预测精度,实现更精准的构效关系解析。
结论
传统药物专利挖掘与构效研究模式高度依赖人工操作,专利检索、文献下载、结构识别、数据归集全流程耗时费力、容错率低,大量重复性工作挤占了科研人员核心分析与创新设计的时间,成为CADD与药物化学研发的效率瓶颈。本文基于豆包、Workbuddy等AI Agent工具,搭建了一套从专利动态监测、全自动下载、智能结构与活性提取,到SAR构效分析的自动化研究管线,以礼来DACRA靶点核心专利WO2025240893为案例,完整验证了AI Agent在药物专利挖掘领域的落地价值与实用性。
实践结果表明,AI Agent可完美替代专利调研全流程重复性人工工作,通过精准的页面切割、化学OCR识别、结构化数据匹配、多重交叉校验,快速输出标准化、可直接复用的分子结构数据集与活性数据表,将原本数天的专利整理工作压缩至数小时,极大提升了前期调研效率。同时,整套AI自动化工作流具备极强的兼容性与衔接性,提取的标准化数据可无缝对接Flare R-基团定性分析、3D-QSAR定量建模等主流CADD研究手段,实现「原始专利数据→结构化数据集→构效规律解析→药物优化指导」的全链路闭环研究。
契合Ash Jogalekar提出的AI药物研发核心逻辑,本研究充分证明:现阶段AI赋能药物研发的核心价值,并非虚无的“智能新药设计”,而是通过自动化工作流重构传统科研流程,解放科研人力,让药化与计算化学人员聚焦于构效机制解读、分子优化策略制定等核心科研工作。未来可通过优化活性构象预测、引入多模型交叉校验、拓展虚拟筛选功能,进一步完善该管线,为靶点立项调研、先导化合物优化、竞品专利技术摸底提供高效、标准化的技术支撑。
附件
- WO2025240893: https://pan.baidu.com/e/1SkstnCJMYAiEnc_Z0zx85Q?pwd=3khj
- WO2026193091: https://pan.baidu.com/e/1xhiJmmRZhID53k3nfZ6ndA?pwd=t8p5
- WO2026193092: https://pan.baidu.com/e/1jVDEzkPv9LjvjBPrnGNBHg?pwd=tvwx
注意:附件是Workbuddy整理,未经人工核验。
使用方法:下载、解压。
- _check.html: 核对表,浏览器打开
- SDF或SMILES.csv: 化合物SMILES、活性数据、以及数据来源,用Flare、Schrodinger等专业工具打开。
文献
- Ash Jogalekar. 2025-09-24. Code, not Drugs: The LLM Revolution in Computational Drug Design. Available at: https://www.linkedin.com/pulse/code-drugs-llm-revolution-computational-drug-design-ash-jogalekar-rdmqc.
- 将DECIMER作为Flare的化学OCR插件. https://mp.weixin.qq.com/s/yXEl8VXOo4D2LBF7hVij4Q
- Flare的R-基团分析(R-Group Analysis). http://blog.molcalx.com.cn/2023/04/01/r-group-analysis.html
- Module containing a C++ implementation of the FMCS algorithm. https://www.rdkit.org/docs/source/rdkit.Chem.rdFMCS.html
- Zhao, H.; Kwapień, K.; Nittinger, E.; Tyrchan, C.; Nilsson, M.; Berglund, S.; Czechtizky, W. AI-Augmented R-Group Exploration in Medicinal Chemistry. J. Chem. Inf. Model. 2025, 65 (5), 2251–2255. https://doi.org/10.1021/acs.jcim.4c02326
- Forge教程 | FieldTemplater搜寻药效团模型. http://blog.molcalx.com.cn/2017/06/24/tutorial-fieldtemplater.html
- 在缺乏靶标结构信息的情况下解析多种DPPIV配体的结合模式. http://blog.molcalx.com.cn/2025/09/27/discerning-binding-modes-of-dipeptidyl-peptidase-iv-binders.html
- 用FieldTemplater预测ROS1抑制剂的生物活性构象. http://blog.molcalx.com.cn/2025/10/17/prediction-of-bioactive-conformation-of-ros1-inhibitors.html